DeepX hoàn tất chip AI biên DX-M2 chạy mô hình 100 tỉ tham số
DeepX, startup chip AI của Hàn Quốc, vừa hoàn tất bước tape-out cho DX-M2, chip AI biên thế hệ thứ hai dùng bộ nhớ PIM của Samsung để chạy mô hình ngôn ngữ tới 100 tỉ tham số chỉ với 5W điện, nhanh hơn tới 6,7 lần theo mô phỏng của hãng.
Ngày 9/11/2026, DeepX công bố đã gửi thiết kế chip DX-M2 sang nhà máy để sản xuất thử, cột mốc được giới chip gọi là tape-out. Đây là chip AI biên thế hệ thứ hai của startup Hàn Quốc, nhắm tới robot, drone, xe hơi và thiết bị IoT.
DX-M2 có gì mới so với thế hệ DX-M1?
DX-M1, thế hệ đầu tiên của DeepX, đã bước vào giai đoạn sản xuất hàng loạt và tập trung vào các ứng dụng thị giác máy tính. DX-M2 đi xa hơn một bước: nó được thiết kế để chạy suy luận cho mô hình ngôn ngữ lớn ngay trên thiết bị, với dải mô hình từ 20 tỉ đến 100 tỉ tham số, tương đương khoảng 3 tỉ đến 20 tỉ tham số kích hoạt trong các mô hình mixture-of-experts.
Con số đáng chú ý nhất là mức tiêu thụ điện. DX-M2 giữ nguyên ngân sách 5W như DX-M1 nhưng đạt 80 TOPS, tốc độ suy luận từ 10 đến 30 token mỗi giây tùy mô hình. Băng thông bộ nhớ tăng gấp ba, từ 50 lên 150 GB/s. Theo Lokwon Kim, nhà sáng lập kiêm CEO DeepX, hiệu suất năng lượng của NPU đã tăng gấp đôi nhờ cải tiến thiết kế, rồi tăng gấp đôi nữa khi chuyển sang tiến trình 2nm. Chip cũng hỗ trợ các kỹ thuật suy luận mới như speculative decoding và TurboQuant, cùng các mô hình mixture-of-experts quy mô lớn.
Bộ nhớ PIM của Samsung giúp tăng tốc gấp 6,7 lần ra sao?
Hầu hết phép suy luận AI đều bị nghẽn ở khâu di chuyển trọng số mô hình giữa bộ nhớ và bộ xử lý, đặc biệt là phép nhân ma trận – vector (GEMV). PIM, viết tắt của processor-in-memory, là cách đưa phép tính vào ngay bên trong chip nhớ để giảm thời gian chờ đợi này. Công nghệ này dự kiến thành chuẩn JEDEC cho LPDDR6, còn DeepX đã làm việc với Samsung một năm rưỡi để tích hợp DX-M2 với LPDDR5x-PIM, bản PIM tùy chỉnh của Samsung.
Mô phỏng của DeepX cho thấy việc dồn phép GEMV sang LPDDR5x-PIM giúp tốc độ tạo token nhanh hơn 6,7 lần với mô hình Llama3.1-8B so với chỉ dùng DX-M2. Tuy nhiên, con số này cần được đọc kèm điều kiện: hiệu năng cao hơn đi cùng mức tiêu thụ điện tổng thể cao hơn 2,7 lần, và trình biên dịch hỗ trợ chế độ này vẫn đang trong giai đoạn hoàn thiện. Hãng đã nhận mẫu LPDDR5x-PIM và đang thử nghiệm trong nội bộ, đồng thời có thể đạt mức tăng tốc gấp đôi mà không vượt khỏi ngân sách điện của chế độ chạy thông thường. Với thế hệ DX-M3 ra mắt năm 2028, hãng sẽ dùng chuẩn LPDDR6 PIM chính thức và kỳ vọng hiệu năng lý thuyết cao hơn 5 đến 8 lần.
DX-M2 nhắm tới robot, xe hơi và AI PC như thế nào?
DeepX xác định bốn thị trường chính cho DX-M2. Với robot, nhiều khách hàng hiện vẫn phát triển nguyên mẫu trên GPU như Nvidia Thor nhưng muốn một lựa chọn tiết kiệm điện và mát hơn khi đưa vào sản phẩm thật. Bộ thư viện phần mềm Newton của hãng cho phép khách hàng chuyển từ nền tảng robot Isaac của Nvidia sang DeepX chỉ bằng cách đổi tên API, với thời gian chuyển đổi dưới một giây theo lời CEO. Phòng thí nghiệm robot của Hyundai Motor Group đã dùng DX-M1 trong nền tảng robot của mình.
Với AI PC, DeepX đang làm việc với các nhà sản xuất Đài Loan để tìm vị trí phù hợp cho laptop và máy trạm. Với ô tô, hãng nhắm tới các con chip công suất thấp có thể chạy trợ lý AI ngay trong xe. Với IoT, DeepX hợp tác với Samsung phát triển smart hub thế hệ mới và tham gia hệ sinh thái AWS IoT để cập nhật mô hình từ xa qua Greengrass. Hãng cũng hợp tác với Intel để tích hợp OpenVINO, đồng thời trao đổi với AMD về nền tảng robot dùng bo mạch Kria.
Khi nào DX-M2 có mặt trên thị trường?
Tape-out mới chỉ là điểm khởi đầu của một hành trình dài trước khi chip đến tay khách hàng. Theo lộ trình DeepX công bố, mẫu thử DX-M2 dự kiến ra mắt vào tháng 3/2027, sản xuất hàng loạt nhắm tới mùa thu 2027. Trong lúc chờ đợi, DX-M1 tiếp tục là sản phẩm tạo doanh thu: DeepX cho biết đã có hơn 100 đơn đặt hàng DX-M1 từ các thị trường lớn, gồm drone, robot, nhà máy thông minh, camera giám sát, hàng không vũ trụ và quốc phòng, y tế cùng IoT. Nhật Bản nổi lên như một thị trường lớn, với hơn 10 công ty hàng đầu đang đánh giá chip của hãng, bên cạnh thị trường Mỹ và Trung Quốc.
Xa hơn, DX-M3 dự kiến ra mắt năm 2028 với thiết kế chiplet, nhắm tới hiệu năng 1 ePOPS ở chuẩn INT8 và dùng LPDDR6-PIM. Thị trường mục tiêu của thế hệ này là các hãng xe và công ty robot hình người, những nơi nhu cầu tính toán đòi hỏi thiết kế đa chiplet.
Vì sao chip AI 5W lại quan trọng lúc này?
Nhiều dự án trung tâm dữ liệu AI đang chậm tiến độ vì thiếu điện, trong khi nhu cầu suy luận vẫn tăng. Lokwon Kim cho rằng thị trường bộ xử lý AI sẽ dịch chuyển ra biên trong 5 đến 10 năm tới, tương tự cách CPU từng lan từ trung tâm dữ liệu ra PC và smartphone. “Nếu chúng ta triển khai mô hình tới 100 tỉ tham số trên thiết bị, chúng ta có thể giảm lưu lượng trung tâm dữ liệu AI hơn 80%”, ông nói, “điều đó có nghĩa là chúng ta có thể có hạ tầng lớn gấp năm lần mà không cần thêm máy chủ AI”.
Tuyên bố này là tầm nhìn của hãng, chưa phải kết quả đo được, và con số 6,7 lần cũng mới dừng ở mô phỏng. Nhưng hướng đi thì rõ ràng: khi mô hình AI ngày càng lớn mà điện cho trung tâm dữ liệu ngày càng khan hiếm, những con chip 5W chạy được mô hình lớn ngay trên thiết bị sẽ có đất diễn riêng, từ robot, drone tới camera thành phố thông minh tại Hàn Quốc, Việt Nam và Singapore.
Ba mốc cần nhớ: mẫu thử DX-M2 vào tháng 3/2027, sản xuất hàng loạt vào mùa thu 2027 và thế hệ chiplet DX-M3 vào năm 2028. Tới lúc đó, hiệu năng thực tế trên silicon thật, chứ không phải trên mô phỏng, mới là thước đo cuối cùng cho tham vọng AI biên của DeepX.
Nguồn tham khảo: DeepX
Bài liên quan
OpenAI sáp nhập đội robot vào nhóm nghiên cứu chính
OpenAI vừa xác nhận với Fortune việc đưa đội robot độc lập vào nhóm nghiên cứu chính và khối Applied, với lý do các mô hình đa năng như GPT-6 Astra giờ đã đủ khả năng điều khiển robot trực tiếp, không cần một đội riêng xây mô hình chuyên biệt.
5 phút đọc
Ngân hàng Nhà nước siết AI chuyển tiền từ hôm nay 15/11
Từ hôm nay 15/11, Thông tư 53/2026/TT-NHNN của Ngân hàng Nhà nước chính thức có hiệu lực, đặt khuôn khổ đầu tiên cho trí tuệ nhân tạo trong ngành ngân hàng. AI được phép tự chuyển tiền thay khách hàng, nhưng chỉ trong hạn mức chặt chẽ và khi khách hàng đã đồng ý trước.
6 phút đọc
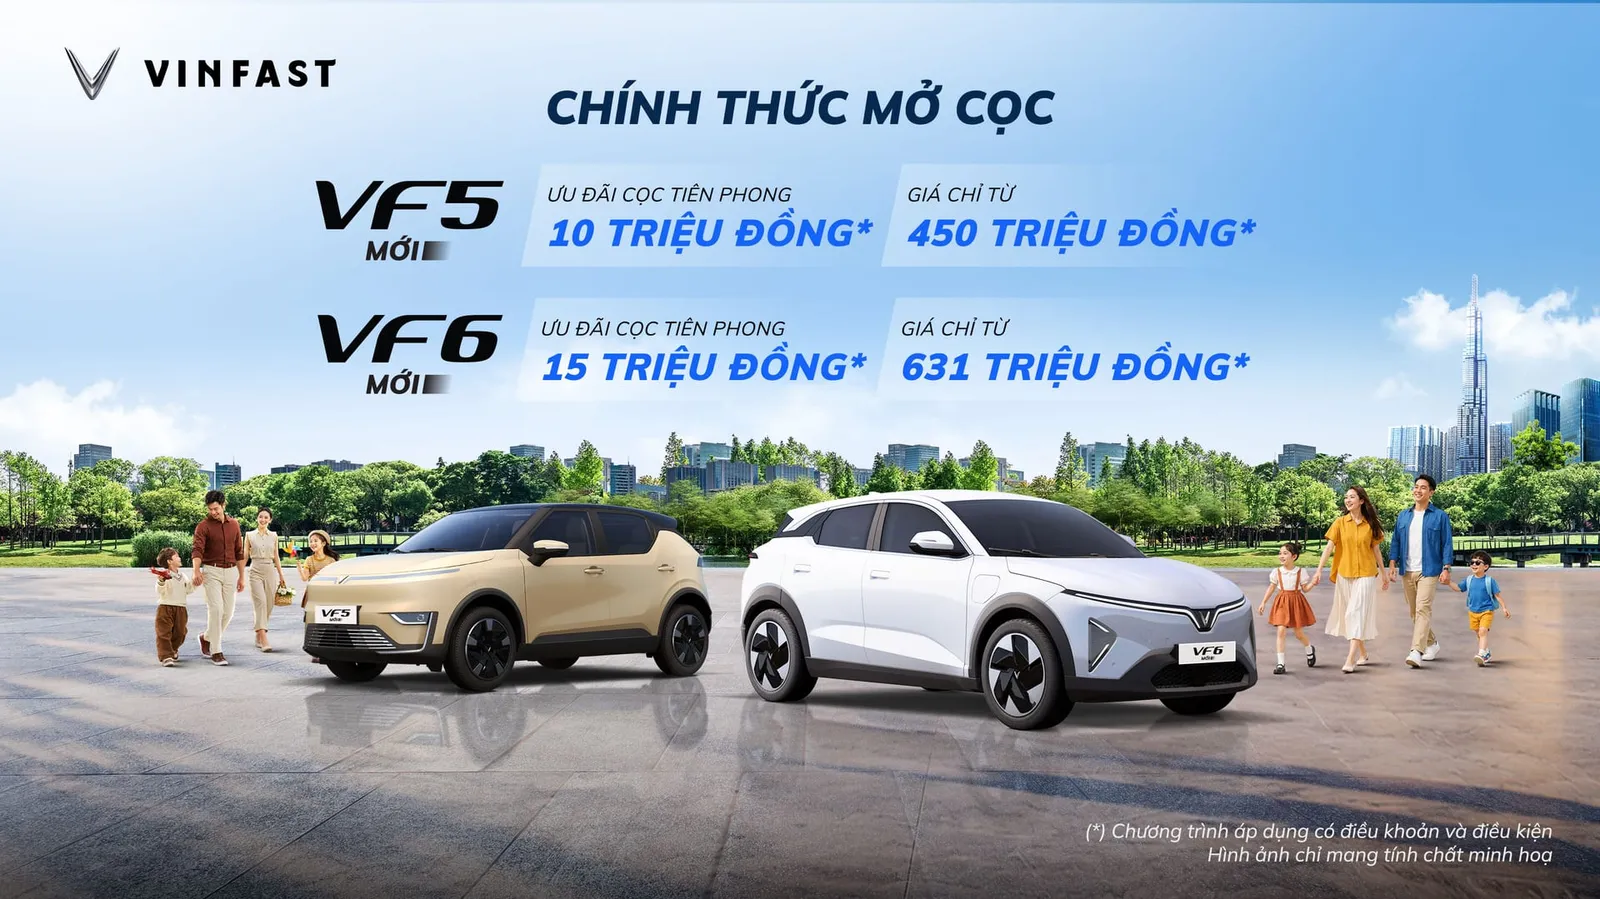
VinFast mở cọc VF 5 và VF 6 mới, giá từ 460 triệu đồng
VinFast vừa mở nhận đặt cọc hai phiên bản mới của VF 5 và VF 6, giá niêm yết từ 460 triệu và 646 triệu đồng. Khách đặt cọc trước hết ngày 18/11 được giảm ngay 10-15 triệu đồng, xe dự kiến giao sau Tết Nguyên đán 2027.
6 phút đọc