Anthropic đưa Claude Fable 5.2 lên đỉnh bảng robot AA-Robotics
Ngày 12/11/2026, Artificial Analysis cập nhật bảng xếp hạng AA-Robotics v0.1: Claude Fable 5.2 của Anthropic đạt 75 điểm, vươn lên dẫn đầu và bỏ xa GPT-6 Astra 6 điểm, đồng thời trở thành mô hình đầu tiên hoàn thành bài đo hộp mà chưa mô hình nào vượt qua kể từ khi bảng ra mắt tháng 10.
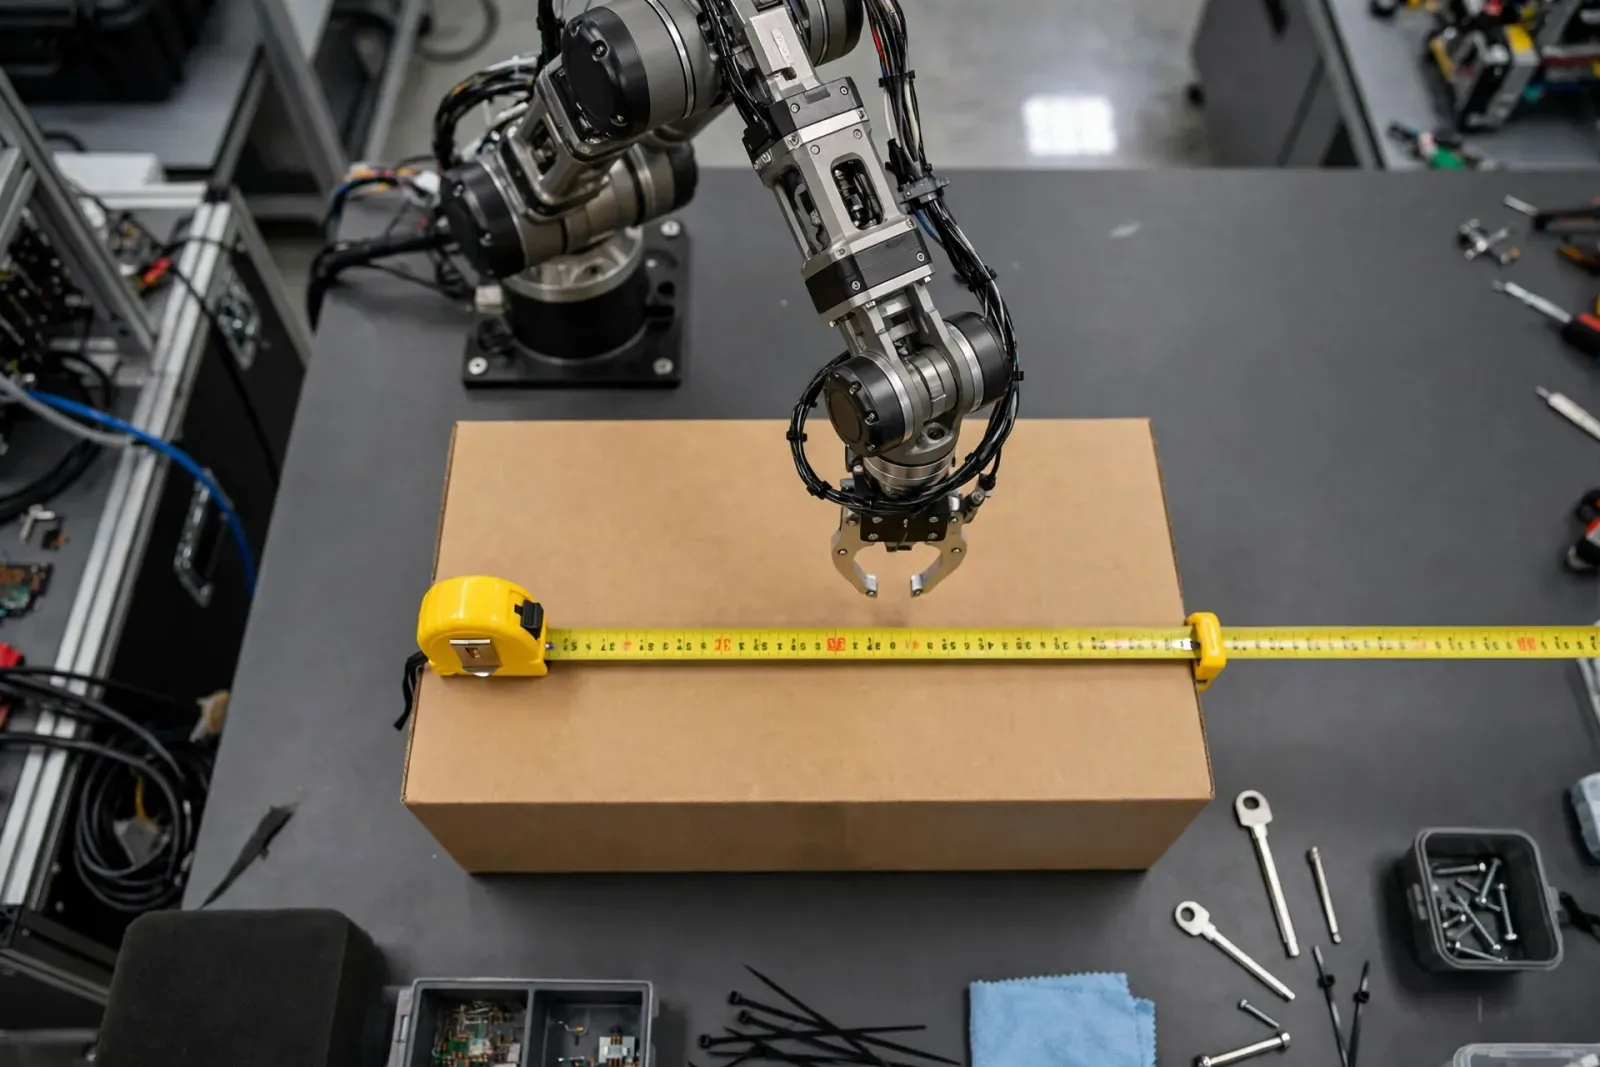
Khác với các bảng đo khả năng viết văn hay lập trình, AA-Robotics bắt mô hình điều khiển một cánh tay robot thật bằng code, nhìn qua camera và tự sửa lệnh khi làm sai. Kết quả lần này là đánh giá độc lập của Artificial Analysis, công bố ngày 12/11, cho thấy một bản nâng cấp cũng đủ thay đổi hoàn toàn thứ hạng.
Fable 5.2 dùng thước dây làm thước đo thị giác
Bài đo hộp nghe đơn giản nhưng lại là bài khó nhất của AA-Robotics: mô hình phải đo chiều dài, chiều rộng, và chiều cao của một chiếc hộp, mỗi số đo phải chính xác trong sai số 2 mm. Từ khi bảng ra mắt tháng 10, chưa mô hình nào hoàn thành. GPT-6 Astra được 0 điểm ở bài này, còn GPT-6.1 Sol và Claude Opus 5.5 chỉ nhận điểm từng phần 17 trên 100.
Fable 5.2 không cầm thước đo từng cạnh như người vẫn làm. Nó giữ thước dây trong khung hình camera, đọc vạch chia in trên thước làm thang đo rồi ước lượng kích thước hộp từ ảnh, biến bài toán điều khiển khéo léo thành bài toán suy luận bằng thị giác, nơi mô hình ngôn ngữ vốn đã mạnh.
Artificial Analysis nhận xét đây là dấu hiệu của khả năng lập kế hoạch: mô hình tự chọn con đường đơn giản hơn khi phần cứng thành nút thắt, thay vì cố bắt chước thao tác của con người.
Bảng xếp hạng AA-Robotics thay đổi ra sao
Bảng xếp hạng mới nhất ghi nhận Claude Fable 5.2 đạt 75 điểm, tiếp theo là GPT-6 Astra 69 điểm, GPT-6.1 Sol 65 điểm, Gemini 4 Argon 55 điểm, Claude Opus 5.5 49 điểm và Claude Fable 5.1 46 điểm. So với bản tiền nhiệm, Fable 5.2 tăng 29 điểm, mức nhảy vọt lớn nhất từng ghi nhận trên bảng này.
AA-Robotics gồm tám nhiệm vụ trên mặt bàn: đặt cá sấu đồ chơi, rót đồ uống, dọn hộp, ghép hình, xếp tháp và đo hộp. Mô hình điều khiển một cánh tay Hiwonder NexArm sáu trục, năm khớp, một kẹp gắp, nhận ảnh từ camera, chạy code Python và gửi lệnh qua HTTP. Mọi mô hình đều làm bài trong điều kiện zero-shot, không được xem ví dụ mẫu mà phải tự suy ra chiến lược rồi điều chỉnh lệnh theo ảnh kết quả.
Cần nói rõ giới hạn: AA-Robotics vẫn là một bảng nghiên cứu nhỏ, chỉ có tám nhiệm vụ trên mặt bàn và một cánh tay robot. Điểm số cao cho thấy mô hình tiến bộ nhanh, nhưng chưa chứng minh được độ tin cậy công nghiệp hay hiệu quả kinh tế khi đưa robot ra khỏi phòng thí nghiệm.
Không chỉ robot, Fable 5.2 dẫn đầu cả bảng trí tuệ
Cú nhảy trên AA-Robotics không phải kết quả đơn lẻ. Trên bảng Intelligence Index của Artificial Analysis, Fable 5.2 dẫn đầu với 64,6%, xếp trên Gemini 4 Carbon 60,0% và Claude Opus 5.5 59,1%, cho thấy mô hình mạnh đồng đều chứ không chỉ giỏi riêng mảng robot.
Trong thông báo ra mắt ngày 9/11, Anthropic cũng công bố kết quả trên RoboDojo Sim, bài kiểm tra mô phỏng robot hai tay điều khiển qua ảnh camera: Fable 5.2 đạt 64,9%, cao hơn hẳn Opus 5.5 với 39,4%, GPT-6 Astra 29,8% và Fable 5.1 27,6%. Hãng cho biết đây là kết quả chạy nội bộ, không phải bài kiểm tra độc lập, nên cần đọc với sự thận trọng tương ứng.
Một con số khác cũng gây chú ý: trên BenchCAD 2.1, bài kiểm tra thiết kế phần cứng, Fable 5.2 đạt 83,5 điểm, vượt Opus 5.5 với 65,3 điểm và Fable 5.1 với 44,4 điểm. Anthropic cho biết đã cùng công ty Diode nhờ mô hình thiết kế ba thiết bị điện tử hoạt động được từ một đoạn mô tả ngắn, gồm loa ngoài USB, hub trợ lý giọng nói và thú cưng ảo cầm tay chạy pin, dù mới ở dạng nguyên mẫu.
Ngoài ra, bảng MKA do Google DeepMind và Artificial Analysis ra mắt ngày 11/11, đo khả năng làm việc trực quan qua 200 nhiệm vụ chuyên môn, cũng đặt Fable 5.2 lên đầu với khoảng 57%, xếp trên Gemini 4 Carbon khoảng 54%. Đây mới là lần chạy đầu tiên của một bảng hoàn toàn mới, nên con số có thể thay đổi khi có thêm mô hình tham gia.
Chậm và đắt, rào cản trước khi robot vào đời thực
Điểm số ấn tượng chưa đồng nghĩa robot sắp vào nhà máy. Artificial Analysis cho biết các mô hình mạnh nhất mất khoảng 30 phút cho mỗi nhiệm vụ trên bàn, chậm hơn người khoảng 100 lần và đắt hơn khoảng 10 lần. Với tốc độ đó, robot điều khiển bằng mô hình ngôn ngữ mới chỉ phù hợp cho nghiên cứu.
Chi phí cũng chênh lệch rất lớn giữa các mô hình. GPT-6.1 Sol tốn 1,93 USD cho mỗi nhiệm vụ ở mức 65 điểm, trong khi GPT-6 Astra tốn tới 16,36 USD cho mỗi nhiệm vụ ở mức 69 điểm. Artificial Analysis chưa công bố chi phí chạy của Fable 5.2 trên AA-Robotics, nên chưa thể so sánh trực tiếp. Tuy nhiên, trên bảng Intelligence Index, tổ chức này ghi chi phí của Fable 5.2 ở mức tối đa là 26,54 USD cho mỗi nhiệm vụ, cao nhất trong 73 mô hình được đo, trong khi Opus 5.5 chỉ tốn 10,04 USD.
Khoảng cách giữa điểm số và chi phí là điều người mua mô hình cần cân nhắc: dẫn đầu bảng nhưng tốn gấp nhiều lần đối thủ sẽ khó thuyết phục doanh nghiệp, trừ khi nhiệm vụ thực sự cần độ chính xác cao nhất.
Mô hình đa năng đang học cách chạm vào thế giới thật
Fable 5.2 và Mythos 5.2 dùng chung một nền tảng mô hình, nhưng Anthropic phân phối khác nhau: Fable mở rộng rãi hơn với các rào chắn an toàn mạnh hơn, chặn nhiệm vụ an ninh mạng rủi ro cao và phần lớn nghiên cứu sinh học, còn Mythos chỉ dành cho người dùng nghiên cứu đã xác minh.
Điều đáng chú ý nhất không nằm ở con số 75 điểm, mà ở cách mô hình đạt được nó: kết hợp cảm nhận qua camera, lập kế hoạch, chọn công cụ và tự sửa sai từ phản hồi qua một API đơn giản. Đây chính là mẫu hình mà các nhà phát triển agent đang theo đuổi.
Với người dùng Việt Nam quan tâm tới AI agent, ba điều cần theo dõi là Artificial Analysis có công bố chi phí chạy của Fable 5.2 hay không, các mô hình khác phản ứng ra sao, và bước đi từ bàn thí nghiệm ra môi trường thật, nơi ma sát và bất ngờ luôn nhiều hơn trong mô phỏng. Runway Praxis-1 , mô hình robot open-weight vừa ra mắt, cũng đang đi theo hướng tương tự.
Fable 5.2 chưa đưa robot vào nhà máy ngay ngày mai, nhưng 75 điểm và bài đo hộp đầu tiên cho thấy mô hình đa năng đang thu hẹp khoảng cách giữa nhìn, nghĩ và làm. Cuộc đua tiếp theo của AI có thể không chỉ là ai viết hay hơn, mà là ai điều khiển được thế giới thật tốt hơn, với điều kiện chi phí và tốc độ phải giảm mạnh trước đã.
Nguồn tham khảo: Artificial Analysis, Anthropic
Bài liên quan
OpenAI giải tán đội robotics để GPT-6 Astra điều khiển robot
OpenAI vừa giải tán đội robotics độc lập và chuyển toàn bộ nhân sự sang các đội nghiên cứu mô hình chung, với lý do các mô hình đa năng như GPT-6 Astra giờ đã đủ khả năng điều khiển robot trực tiếp. Quyết định được Fortune đưa tin ngày 13/11 và được người phát ngôn của OpenAI xác nhận.
6 phút đọc
Anthropic để Claude tự điều phối nhiều luồng code song song
Anthropic vừa nâng cấp Claude Code Projects với điều phối viên chủ động hơn, có thể trả lời ngay trong chat dự án và tự cập nhật tiến độ khi các luồng AI làm việc song song. Đợt cập nhật được công bố ngày 13/11, đang mở dần dưới dạng beta cho người dùng Pro, Max và Ultra.
6 phút đọc
Cursor công bố kết quả điều tra vụ lộ khóa Fireworks
Sau hai tuần điều tra, Cursor xác nhận kẻ tấn công dùng khóa truy cập do hãng cấp cho nhà cung cấp Fireworks để đánh cắp dữ liệu, rồi phát tán bản giả mạo của extension Claude Code tới tối đa 5.000 người dùng trong ngày 29/10. Sự cố đã được chặn đứng từ 1/11.
6 phút đọc