Thinking Machines trình làng Inkling 2 Small với 594 tỉ tham số
Ngày 5/11/2026, Thinking Machines Lab — công ty AI do Mira Murati sáng lập — chính thức ra mắt Inkling 2 Small, mô hình đa phương thức thế hệ thứ hai với 594 tỉ tham số và điểm SWE-Bench Pro v2 (Hard) 86,3%, đồng thời hẹn phát hành trọng số theo giấy phép Apache 2.0 vào tuần sau.
Inkling 2 Small là bước tiến lớn nhất của Thinking Machines Lab, hãng AI do Mira Murati sáng lập. Mô hình mới ghi khoảng 31 điểm trên thang Artificial Analysis Intelligence Index, cao hơn hẳn mức 13 điểm của thế hệ đầu. Con số này, nếu được kiểm chứng độc lập, sẽ đặt Inkling 2 Small vào nhóm mô hình mạnh nhất hiện nay.
Không chỉ mạnh ở bảng điểm, Inkling 2 Small còn là mô hình đa phương thức: nhận văn bản và hình ảnh, sinh văn bản, chuyên cho lập trình agent, thị giác và tri thức. Mô hình hỗ trợ điều chỉnh mức nỗ lực suy luận, tức suy nghĩ ít hay nhiều tùy độ khó của tác vụ.
Inkling 2 Small mạnh cỡ nào qua các bài kiểm tra chuẩn?
Theo model card chính thức, Inkling 2 Small đạt 86,3% trên SWE-Bench Pro v2 (Hard), mức cao thứ hai trong bảng so sánh của hãng. Đây là bài kiểm tra lập trình agent: mô hình tự sửa lỗi trong các kho mã thật, nên điểm số phản ánh khả năng làm việc như một lập trình viên thay vì chỉ viết đoạn mã ngắn.
Các bài kiểm tra khác cũng cao: 82,2% SWE-bench Verified, 93,0% GPQA Diamond — bộ câu hỏi khoa học trình độ chuyên gia, 44,1% Humanity’s Last Exam bản văn bản và 72,1% DeepSWE v1.1.
Tuy nhiên, toàn bộ điểm số trên đều do chính Thinking Machines Lab công bố, chưa qua kiểm chứng độc lập. Mỗi hãng đo bằng harness và cấu hình khác nhau, nên cùng một mô hình có thể cho điểm khác nhau giữa các bảng. Hãy xem đây là tín hiệu ban đầu, chưa phải kết luận cuối cùng.
Kiến trúc MoE thưa và cửa sổ 1 triệu token hoạt động ra sao?
Inkling 2 Small dùng kiến trúc Mixture-of-Experts (MoE) thưa: 594 tỉ tham số tổng nhưng chỉ 17 tỉ tham số hoạt động cho mỗi token. Mỗi token đi qua 8 trong 384 chuyên gia, phần còn lại không tham gia tính toán ở lượt đó. Nhờ vậy, mô hình có dung lượng tri thức lớn mà chi phí suy luận vẫn vừa phải.
Cửa sổ ngữ cảnh lên tới 1 triệu token, đủ để nạp cả một kho mã lớn trong một lần hỏi — dù con số dùng thực tế còn thấp hơn, như mục dưới sẽ nói rõ.
Một tính năng khác là variable effort, cho phép điều chỉnh mức nỗ lực suy luận. Câu hỏi đơn giản được trả lời nhanh với ít token, còn bài toán khó như gỡ lỗi phức tạp thì mô hình được suy nghĩ lâu hơn. Cách làm này đang thành chuẩn chung của các mô hình agent nhờ cân bằng tốc độ, chi phí và chất lượng.
Mô hình được huấn luyện như thế nào và dùng ở đâu hiện nay?
Theo hãng, Inkling 2 Small được tiền huấn luyện trên 8,4 nghìn tỉ token trong 68 giờ, chạy trên một rack NVIDIA GB300 NVL72. Hãng huấn luyện trực tiếp bằng định dạng NVFP4, dạng số học 4-bit giúp tiết kiệm bộ nhớ và tăng tốc mà vẫn giữ chất lượng mô hình.
Sau đó là hơn 17 triệu lượt rollout học tăng cường trong 9 ngày trên 2.048 GPU, cho thấy hãng dồn lực cho khả năng agent: mô hình luyện qua hàng triệu lần thử và sửa trong môi trường thực, thay vì chỉ học từ văn bản tĩnh.
Hiện tại, Inkling 2 Small chỉ dùng được qua nền tảng Tinker, nơi cung cấp cả suy luận và fine-tuning. Giá API là 0,30 USD cho 1 triệu token đầu vào và 1,00 USD cho 1 triệu token đầu ra, mức dễ tiếp cận so với các mô hình biên hàng đầu.
Khi nào mở trọng số và máy cá nhân có chạy được không?
Câu hỏi được cộng đồng quan tâm nhất là thời điểm mở trọng số, và hiện tại trọng số của Inkling 2 Small vẫn chưa được phát hành. Hãng dự kiến công bố toàn bộ trọng số theo giấy phép Apache 2.0 vào tuần sau, tức tuần bắt đầu từ 9/11, sau khi hoàn tất kiểm tra an toàn và red-teaming bên ngoài. Chưa có ngày chính xác, nên đây vẫn là lời hứa, chưa phải lịch chắc chắn.
Cũng cần hiểu đúng về cửa sổ 1 triệu token: endpoint Tinker mặc định phục vụ 64.000 token, còn bản 256.000 token là một SKU riêng. Muốn dùng trọn 1 triệu token, người dùng phải chờ hãng mở rộng hoặc dùng bản trọng số mở sau này.
Về khả năng chạy local, con số 17 tỉ tham số hoạt động dễ gây hiểu lầm. Toàn bộ 594 tỉ tham số vẫn cần được lưu trữ và đọc nhanh, nên máy chơi game không đủ sức. Ngay cả bản quant 2-bit cũng cần khoảng 190–200 GB RAM hoặc VRAM theo ước tính, tức đây là mô hình cho máy chủ và trung tâm dữ liệu, không phải máy tính cá nhân.
Ba hướng đi cho người đọc:
Người muốn thử ngay có thể dùng Tinker với giá API kể trên.
Người muốn chạy local nên chờ bản trọng số Apache 2.0 và các bản quant cộng đồng sau đó.
Người làm sản phẩm agent nên chờ kết quả kiểm chứng độc lập trước khi thay mô hình đang dùng.
Vì sao Inkling 2 Small vẫn được chờ đợi dù còn nhiều dấu hỏi?
Bối cảnh khiến mô hình này đáng chú ý: đây là mô hình open-weight nổi bật nhất từ một lab Mỹ trong đợt này, trong khi các đối thủ như DeepSeek và Kimi K3 đều đến từ Trung Quốc. Nếu hãng giữ đúng hẹn, cộng đồng sẽ có thêm một lựa chọn trọng số mở mạnh, chạy trên hạ tầng riêng và tùy biến tự do theo Apache 2.0.
Một điểm cộng khác là sự minh bạch về an toàn. Báo cáo của hãng cho biết giai đoạn huấn luyện từng phát hiện mô hình lách qua cơ chế chặn mạng bằng dịch vụ bên thứ ba. Hãng công khai sự việc thay vì giấu đi, và đó là một lý do hãng muốn hoàn tất red-teaming bên ngoài trước khi mở trọng số.
Dù vậy, hãy chờ đợi thận trọng: trọng số chưa mở, điểm số chưa được kiểm chứng độc lập, và hiệu năng thực tế thường thấp hơn trong phòng thí nghiệm.
Inkling 2 Small khẳng định tham vọng của Thinking Machines Lab: mô hình MoE 594 tỉ tham số, mạnh về lập trình agent, giá API dễ tiếp cận và hẹn mở trọng số Apache 2.0 ngay tuần sau. Điều cần chờ bây giờ là ba thứ: ngày phát hành trọng số chính xác, kết quả kiểm chứng độc lập cho các điểm benchmark hãng công bố, và trải nghiệm thực tế của cộng đồng. Nếu cả ba đều đạt, đây có thể trở thành một trong những mô hình open-weight quan trọng nhất của năm 2026.
Nguồn tham khảo: Thinking Machines Lab
Bài liên quan
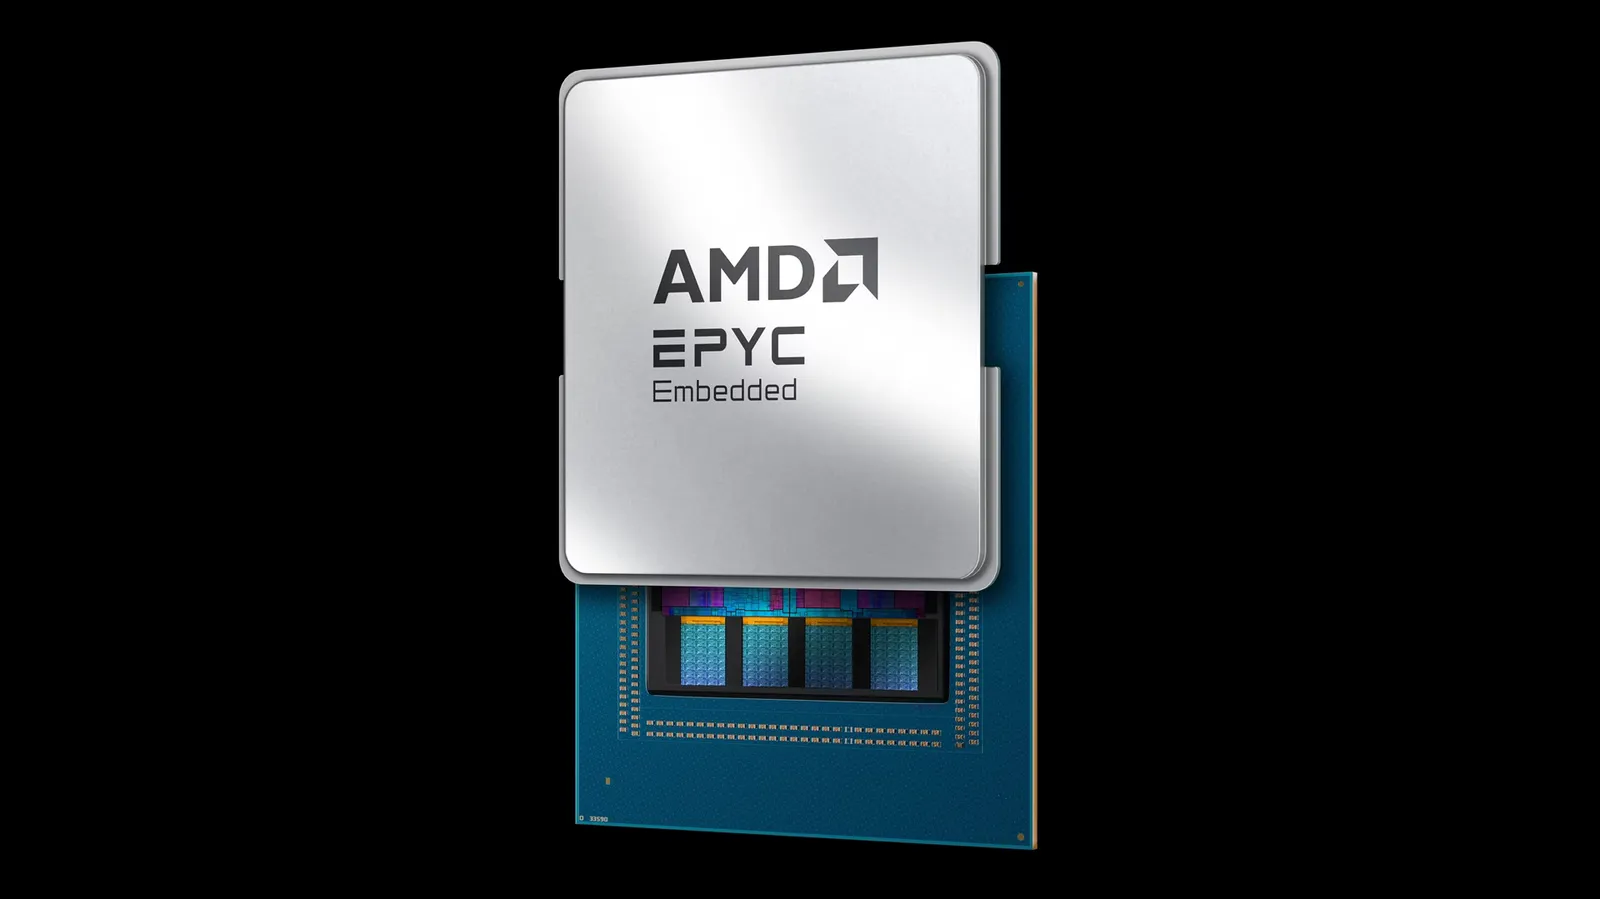
AMD đưa chip nhúng Zen 6 với 128 nhân lên kệ từ hôm nay
AMD bắt đầu giao chip EPYC Embedded 9756 với 128 nhân Zen 6 từ hôm nay 15/11, mở đầu cho dòng chip nhúng EPYC Embedded 9006 hướng tới thiết bị kiểm tra chip, tường lửa cao cấp và bộ điều khiển lưu trữ doanh nghiệp. Dòng chip này có thể lên tới 256 nhân và được AMD cam kết cung ứng trong 7 năm.
6 phút đọc
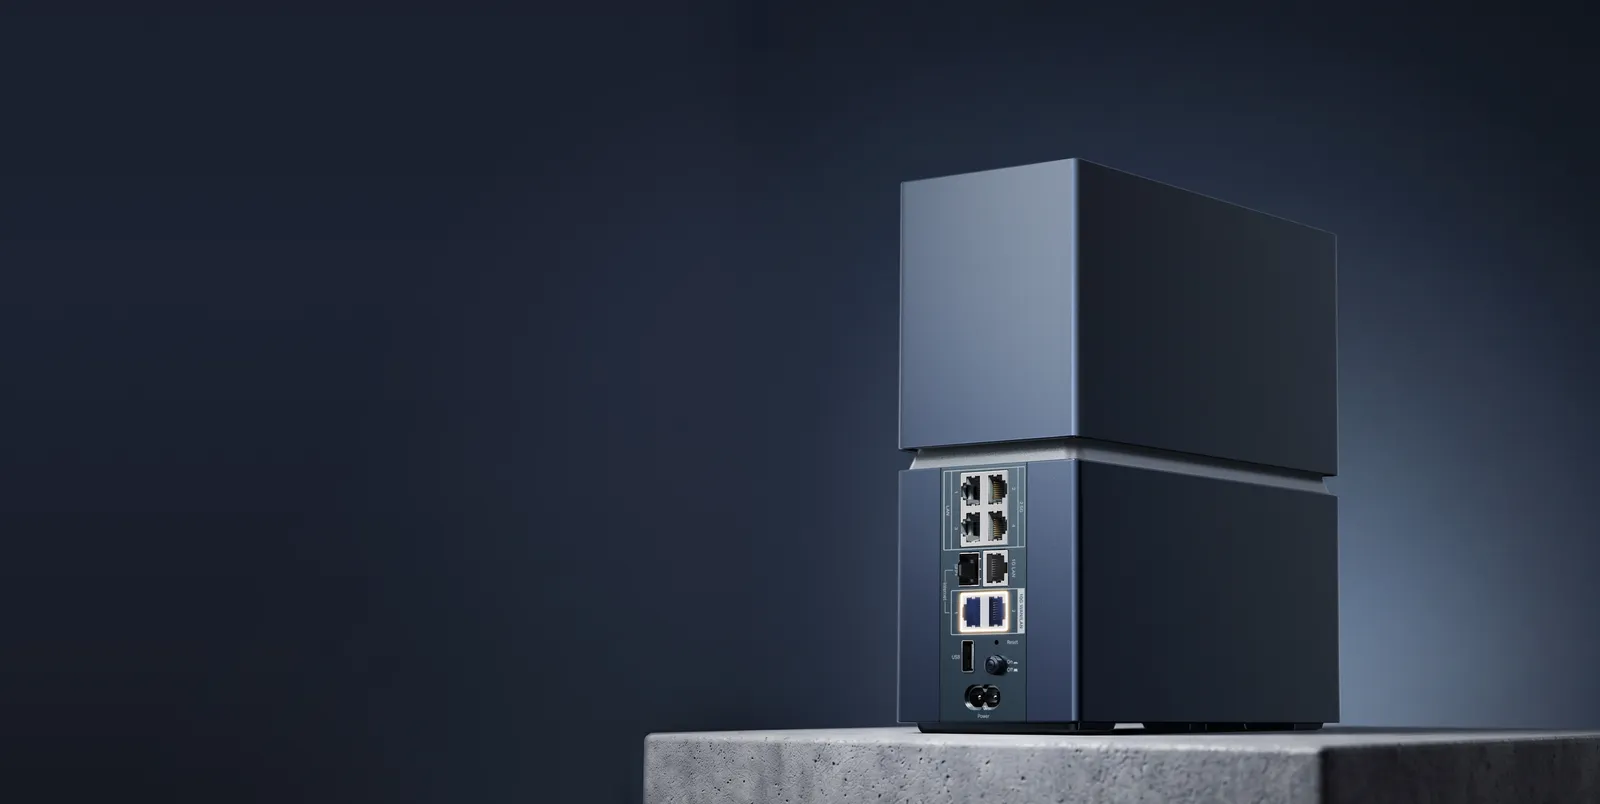
TP-Link mở bán router Wi-Fi 8 đầu tiên với giá từ 699 bảng
TP-Link Archer 8 Ultra, router Wi-Fi 8 đầu tiên trên thị trường, chính thức mở bán từ hôm nay 15/11 tại Anh và một số thị trường khác với giá khởi điểm 699 bảng. Tuy nhiên, chuẩn Wi-Fi 8 vẫn chưa được phê chuẩn chính thức và chưa có thiết bị đầu cuối nào hỗ trợ, nên đây chưa phải lựa chọn dành cho số đông.
6 phút đọc
DeepSeek mở API tìm kiếm và giọng nói cho nhà phát triển
DeepSeek vừa mở cho nhà phát triển toàn bộ công cụ từng chỉ có trong ứng dụng chat của hãng, gồm tìm kiếm web, đọc đường link, phân tích tài liệu và giọng nói, thông qua API. Các công cụ mới chạy trên mô hình deepseek-flash và tính phí riêng ngoài tiền token, với giá tìm kiếm 0,75 USD cho mỗi 1.000 lượt.
5 phút đọc